잘 돌아간다고, 제대로 돌아가는 건 아니었다.
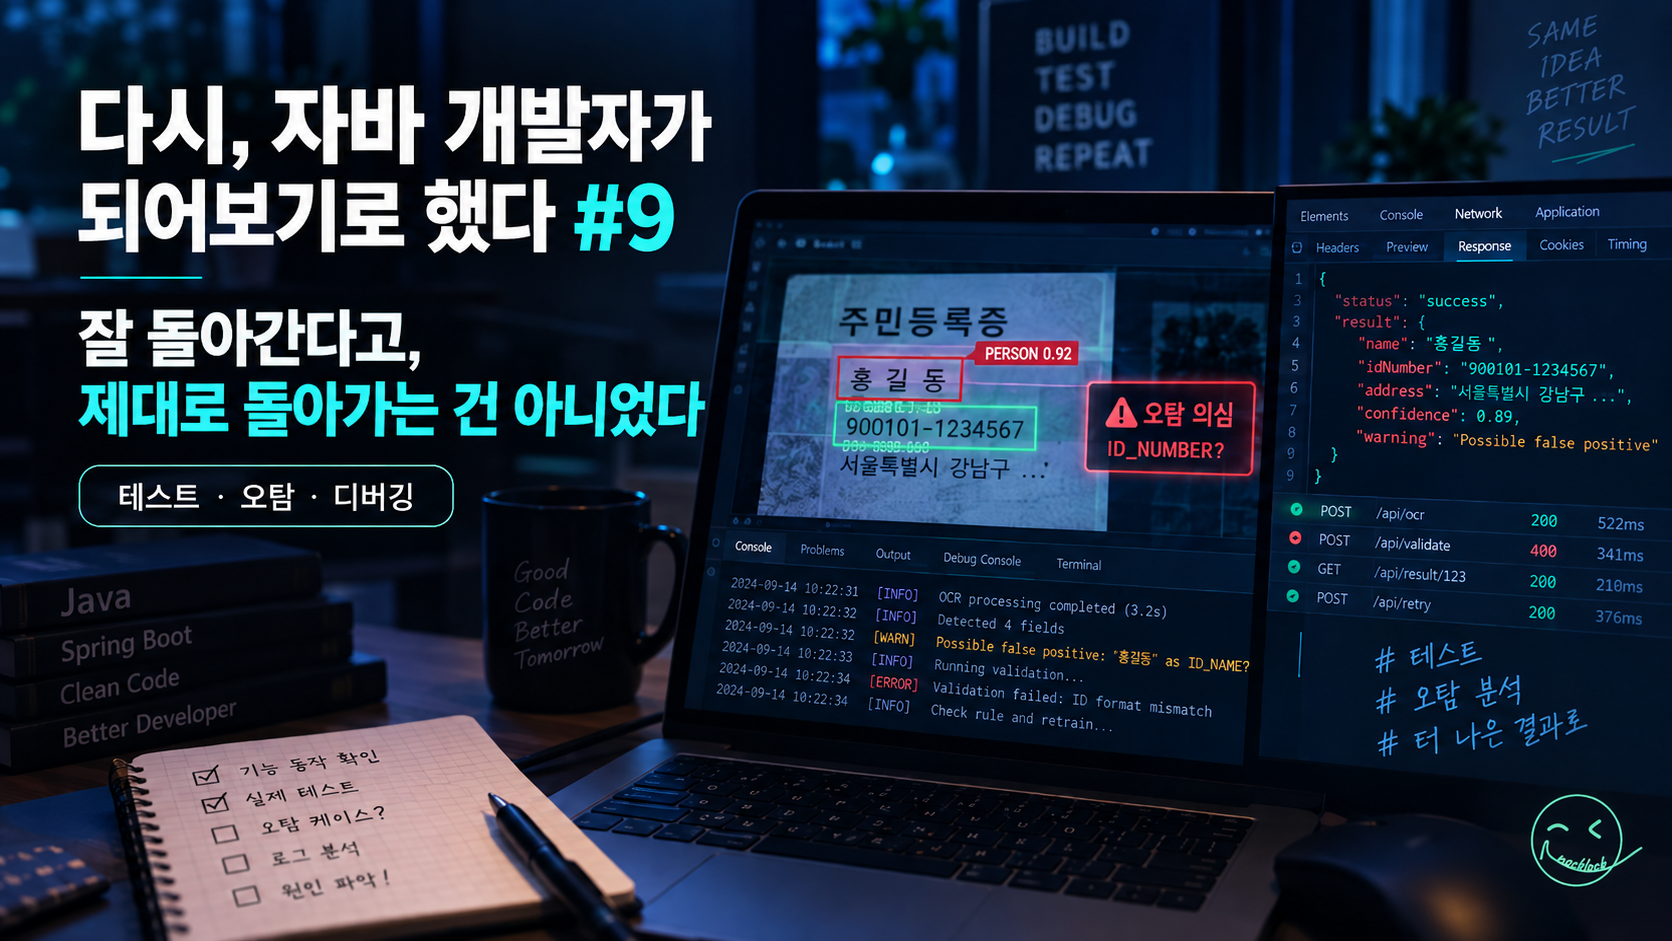
프론트 화면을 붙이고 실제 Spring Boot API까지 연결하니 꽤 그럴듯해졌다.
이미지를 올리고 분석 버튼을 누르면 서버로 요청이 넘어가고, OCR을 거쳐 개인정보를 찾고, 메타데이터와 위험도를 분석한 뒤 결과가 화면에 표시됐다.
브라우저의 Network 탭을 열어봐도 200 OK.
서버 로그에도 큰 에러는 없었다.
처음엔 생각했다.
“됐다.”
그런데 직접 여러 이미지를 넣어보기 시작하니 조금 다른 이야기가 보이기 시작했다.
에러가 없는데 결과가 이상했다
이번 프로젝트에서는 사진 안에 있는 개인정보를 찾아내야 했다.
이름이나 전화번호, 이메일, 주소 같은 정보를 OCR로 읽고, 읽어온 문자열을 다시 분석해서 어떤 종류의 개인정보인지 판단한다.
흐름 자체는 단순하다.
사진을 올린다.
OCR이 글자를 읽는다.
개인정보인지 판단한다.
위험도를 계산한다.
결과를 화면에 보여준다.
여기까지는 잘 돌아갔다.
그런데 테스트 이미지를 하나씩 넣어보니 문제가 생겼다.
분명 주소가 아닌데 주소처럼 잡히기도 하고, 일반 숫자가 민감한 번호처럼 분류되기도 했다. 반대로 사람이 보기에는 개인정보인데 탐지하지 못하는 경우도 있었다.
재미있는 건 프로그램은 멀쩡했다는 것이다.
서버가 죽은 것도 아니고 예외가 발생한 것도 아니다.
API 응답도 정상적으로 돌아왔다.
그냥 틀린 답을 아주 정상적으로 반환하고 있었다.
그때 다시 느꼈다.
에러가 나지 않는 것과 제대로 동작하는 것은 전혀 다른 문제였다.
어디에서 틀렸는지 찾아가기
결과가 이상하다고 해서 바로 코드를 수정할 수 있는 건 아니었다.
먼저 어디에서 문제가 시작됐는지를 찾아야 했다.
OCR이 처음부터 글자를 잘못 읽은 건지, OCR 결과는 정상인데 개인정보 판별 로직에서 잘못 분류한 건지, 서버 결과는 정상인데 JavaScript에서 화면에 잘못 표시한 건지 하나씩 확인했다.
이럴 때 다시 익숙한 화면들을 오가게 됐다.
브라우저에서는 Network와 Console을 보고, IntelliJ에서는 Spring Boot 로그를 확인했다.
그리고 실제 API가 반환한 JSON도 계속 비교했다.
예를 들어 화면에 이상한 개인정보가 하나 표시된다면 제일 먼저 API 응답부터 확인했다.
{
  "type": "ADDRESS",
  "value": "어떤 문자열",
  "confidence": 0.82
}
여기서부터 거꾸로 올라가는 식이었다.
서버가 이미 ADDRESS라고 판단했다면 화면의 문제가 아니다.
그러면 탐지 로직을 본다.
탐지 로직에 문제가 없다면 OCR이 넘겨준 원본 문자열을 다시 본다.
생각보다 단순한 과정인데 실제 개발에서는 이런 식으로 하나씩 범위를 좁혀가는 시간이 꽤 길었다.
OCR이 읽었다고 끝이 아니었다
처음 OCR을 붙였을 때는 글자를 읽어오는 것 자체가 신기했다.
사진을 넣었는데 프로그램이 그 안의 문자를 찾아낸다.
그런데 실제 서비스처럼 만들려고 하니 그 다음부터가 더 중요했다.
OCR이 문자열을 반환했다고 해서 그 문자열이 반드시 정확한 것도 아니고, 정확하게 읽었다고 해서 그것이 어떤 정보인지 바로 알 수 있는 것도 아니었다.
예를 들어 숫자가 있다고 하자.
그게 전화번호인지, 날짜인지, 일반적인 숫자인지, 다른 식별번호의 일부인지 판단해야 한다.
그래서 결국 이런 구조가 됐다.
OCR → 문자열 분석 → 패턴 확인 → 개인정보 유형 분류 → 위험도 계산
하나의 결과가 나오기까지 생각보다 여러 단계가 있었다.
그리고 앞 단계에서 작은 오차가 발생하면 뒤쪽 결과까지 그대로 영향을 받는다.
OCR이 글자 하나를 잘못 읽으면 정규식에 걸리지 않을 수도 있고, 반대로 우연히 특정 패턴과 비슷해져서 개인정보로 잘못 탐지될 수도 있다.
AI도 그냥 믿으면 안 됐다
이번 프로젝트에서는 LLM도 사용하고 있다.
처음에는 AI가 분석 결과를 만들어주면 꽤 많은 부분을 해결할 수 있을 것 같았다.
그런데 이것도 마찬가지였다.
AI가 자연스럽게 설명한다고 해서 그 결과가 항상 맞는 것은 아니다.
그래서 AI에게 모든 판단을 맡기기보다는, 프로그램이 먼저 계산할 수 있는 것들은 최대한 코드에서 처리하고 AI는 그 결과를 바탕으로 설명하거나 보조하는 역할에 가깝게 두려고 했다.
이 과정에서 AI를 사용하는 것과 AI에 의존하는 것은 조금 다르다는 생각도 들었다.
결국 서비스의 결과에 책임을 지는 건 AI가 아니라 내가 작성한 프로그램이다.
테스트라는 말을 조금 다르게 보게 됐다
예전에는 테스트라고 하면 JUnit이나 테스트 코드부터 떠올렸다.
물론 그런 테스트도 중요하다.
그런데 이번에는 조금 더 단순한 테스트를 정말 많이 했다.
내가 직접 사용자가 되어보는 것이다.
이미지를 올려본다.
분석 버튼을 누른다.
결과를 본다.
이상한 부분이 있으면 서버 응답을 확인한다.
로그를 본다.
코드를 수정한다.
그리고 다시 같은 이미지를 넣어본다.
Build → Test → Debug → Repeat
대표 이미지에 넣은 문구처럼 정말 이 과정을 계속 반복했다.
신기하게도 기능을 하나 새로 만드는 것보다 이미 만들어놓은 기능을 제대로 동작하게 만드는 시간이 더 오래 걸리기도 했다.
그래도 이 과정이 재미있었다
예전 회사에서는 내가 작성한 코드가 실제 사용자에게 어떻게 보이는지까지 확인하지 못한 경우도 많았다.
백엔드 기능을 만들고 API가 정상적으로 동작하면 내 역할이 끝나는 경우도 있었다.
이번에는 처음부터 끝까지 직접 만들고 있다.
그래서 내가 만든 코드의 결과를 그대로 내가 보게 된다.
잘못 만든 것도 그대로 보인다.
조금 부끄러운 결과가 화면에 튀어나오기도 한다.
그런데 오히려 그래서 재미있었다.
“왜 이렇게 나왔지?”
그 질문 하나를 가지고 로그를 따라가고 코드를 찾아가다 보면 어디선가 원인이 나온다.
그리고 다시 실행했을 때 원하는 결과가 나오면 그 작은 변화가 꽤 크게 느껴졌다.
이제는 더 만드는 것보다, 제대로 끝내는 단계
프로젝트를 진행하다 보면 이상하게 할 일이 계속 생긴다.
이것도 추가하고 싶고, 저것도 개선하고 싶다.
테스트를 하면 할수록 부족한 부분도 더 많이 보인다.
아마 마음만 먹으면 며칠 동안 계속 기능을 추가할 수도 있을 것 같다.
하지만 이번에는 여기에서 한 가지를 더 배우고 있다.
계속 만드는 것만이 개발은 아니라는 것.
어디까지 만들 것인지 결정하고, 지금 만들어놓은 기능을 테스트하고, 다른 사람이 봐도 이해할 수 있도록 정리하고, 하나의 결과물로 끝내는 과정도 개발의 일부다.
처음에는 프로그램이 실행되는 것만으로 꽤 기뻤다.
지금은 조금 욕심이 생겼다.
실행되는 프로그램이 아니라,
제대로 동작하는 프로그램을 만들고 싶다.
그리고 이제 이번 프로젝트도 슬슬 마지막 단계로 가고 있다.
다음 편에서는 코드를 더 작성하는 이야기가 아니라,
만들어놓은 프로젝트를 어떻게 끝내는지에 대해 적어보려고 한다.
'RE:개발자' 카테고리의 다른 글
| 서버에 올리면 끝인 줄 알았다 — Docker를 처음 제대로 써봤다 | RE:개발자 #11 (0) | 2026.09.22 |
|---|---|
| 내 컴퓨터에서는 잘 되는데, 다른 사람도 쓸 수 있어야 했다 | RE:개발자 #10 (0) | 2026.09.21 |
| RE:개발자 — 다시 개발자가 되어가는 기록 | 전체 목차 (0) | 2026.09.20 |
| AI를 붙이면 끝일 줄 알았다, 실제 테스트는 달랐다 | RE:개발자 #8 (0) | 2026.09.19 |
| 프론트엔드를 붙였더니, 드디어 서비스처럼 보이기 시작했다 | RE:개발자 #7 (0) | 2026.09.19 |